tardis
Pourquoi les trains français sont-ils en retard ? L'essentiel du travail a porté sur les données : nous sommes partis d'un export SNCF volontairement sale, avons nettoyé des années de statistiques de ponctualité ligne par ligne, puis les avons explorées jusqu'à faire apparaître les tendances, des causes de retard aux pires lignes et aux pires mois. Les modèles de prédiction et le tableau de bord interactif sont venus ensuite, sur cette base.
Contexte
Projet de data science d'Epitech construit sur les statistiques mensuelles de ponctualité de la SNCF, une ligne par mois et par couple gare de départ / gare d'arrivée. L'export avait été volontairement abîmé : le premier défi était de pouvoir faire confiance aux données avant d'en tirer la moindre conclusion.
Réalisations
- Nettoyage des données : doublons supprimés, dates réparées, nombres de trains négatifs ou fractionnaires corrigés, retards incohérents écartés, noms de gares normalisés, valeurs manquantes complétées, et nouvelles colonnes (année, mois, ligne, mois à fort retard) calculées
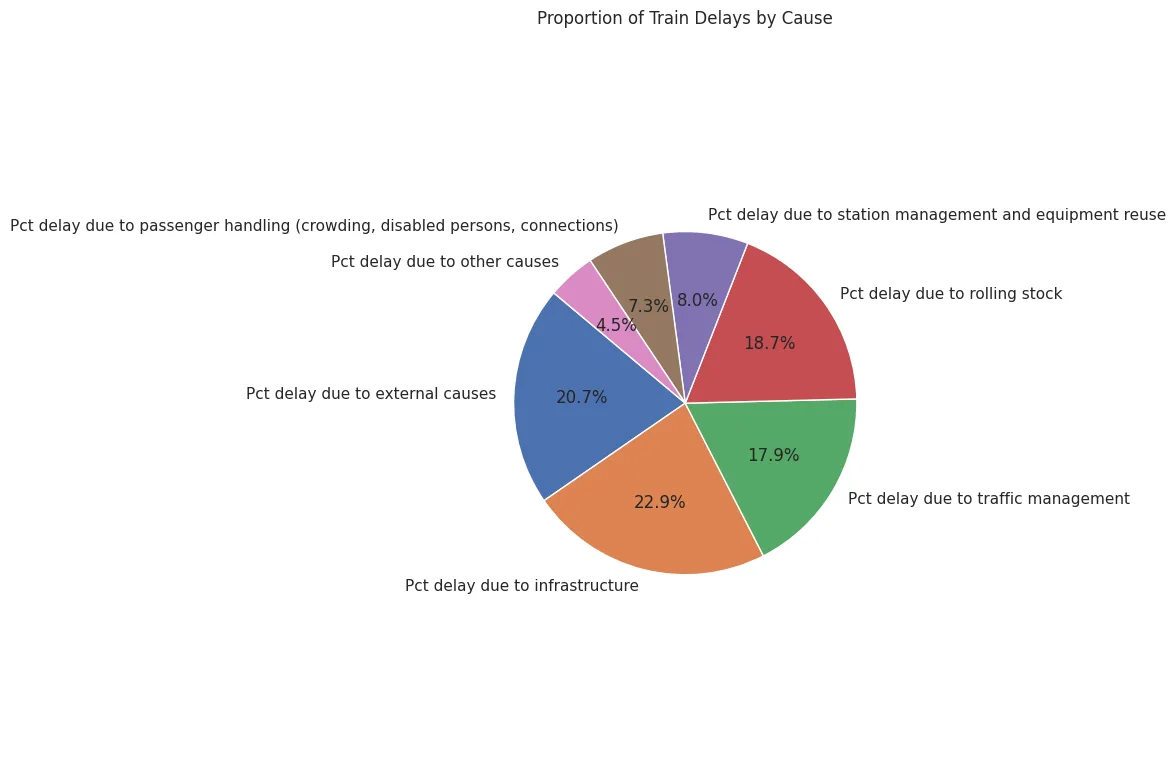
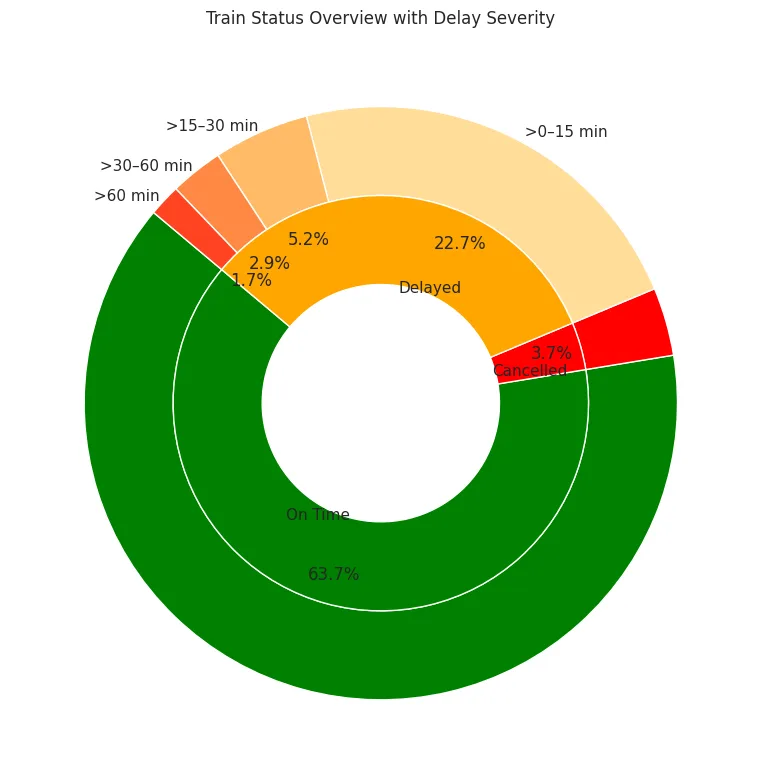
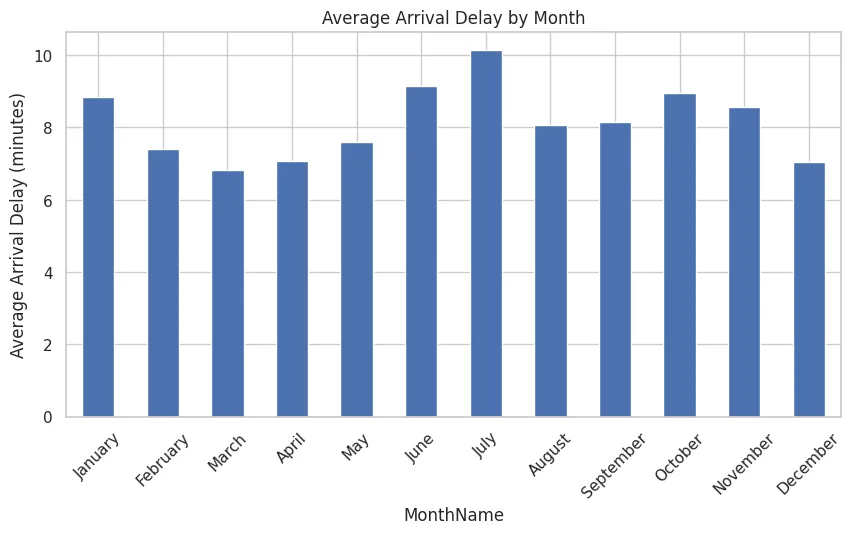
- Analyse exploratoire : trains prévus et annulés mois par mois, lien entre retard au départ et à l'arrivée, part de chaque cause de retard, les 50 lignes les plus en retard, répartition par mois et par jour de la semaine, et distribution des retards
- Modèles sur les données nettoyées : régressions (linéaire, arbre de décision, forêt aléatoire) pour prédire les retards moyens, et classifieurs pour le risque d'au moins une annulation, comparés par RMSE, R², précision et ROC AUC
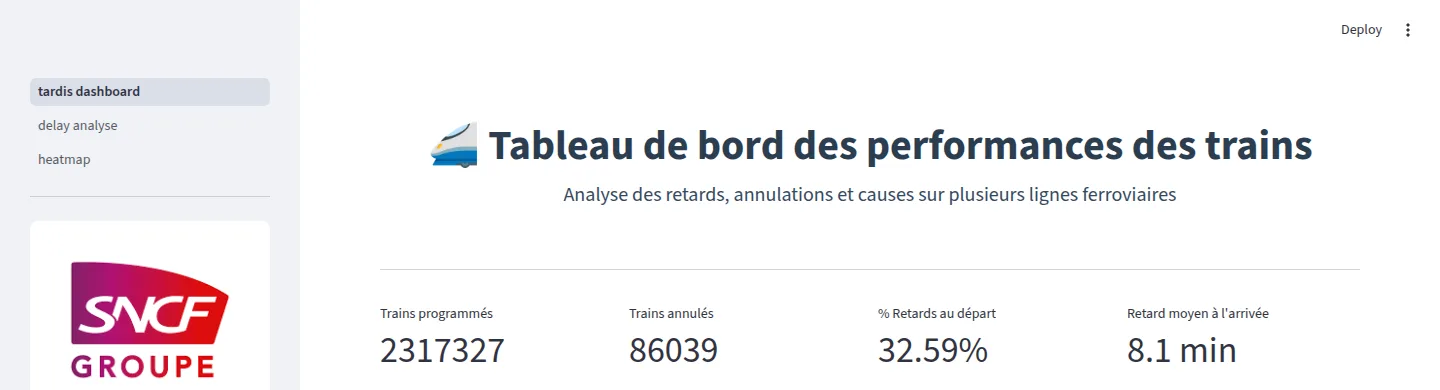
- Un tableau de bord Streamlit multi-pages : chiffres clés, tendances mensuelles, vue par couple de gares, et carte de corrélation des causes de retard